TranscribetoText.aiは最高の文字起こし体験の提供に取り組んでおり、その一環として話者分離を導入し、文字起こしをより正確で使いやすくしています。話者分離(「話者認識」や「話者の割り当て」とも呼ばれます)とは、音声ファイル内の話者を識別して分けるプロセスです。この機能は、何が話されたかだけでなく、誰が話したかも明確にした文字起こしを作成するうえで欠かせません。
文字起こしで話者分離が重要な理由
複数の話者がいる場面では、テキスト文書で会話の流れを追うのはすぐに難しくなります。話者分離は会話の中で各話者の発言を区切るため、会議、インタビュー、パネルディスカッション、カスタマーサービスの録音で特に役立ちます。これがないと、文字起こしは一人の独白のように見え、誰が話しているのか区別しにくくなります。特に意見が分かれる重要な議論では混乱を招きかねません。
話者の割り当てにより、読み手はライブの会話のように文字起こしを追え、誰の発言か、どんな意図かを把握しやすくなります。この機能は、法律関係の文字起こし、学術研究、メディアのインタビュー、顧客フィードバックの分析など、話者の区別が重要な場面で欠かせません。異なる声を認識し、発言内容を各話者に結び付けることで、安心して参照、引用、分析できる文字起こしを作成します。
TranscribetoText.aiでの話者分離の仕組み
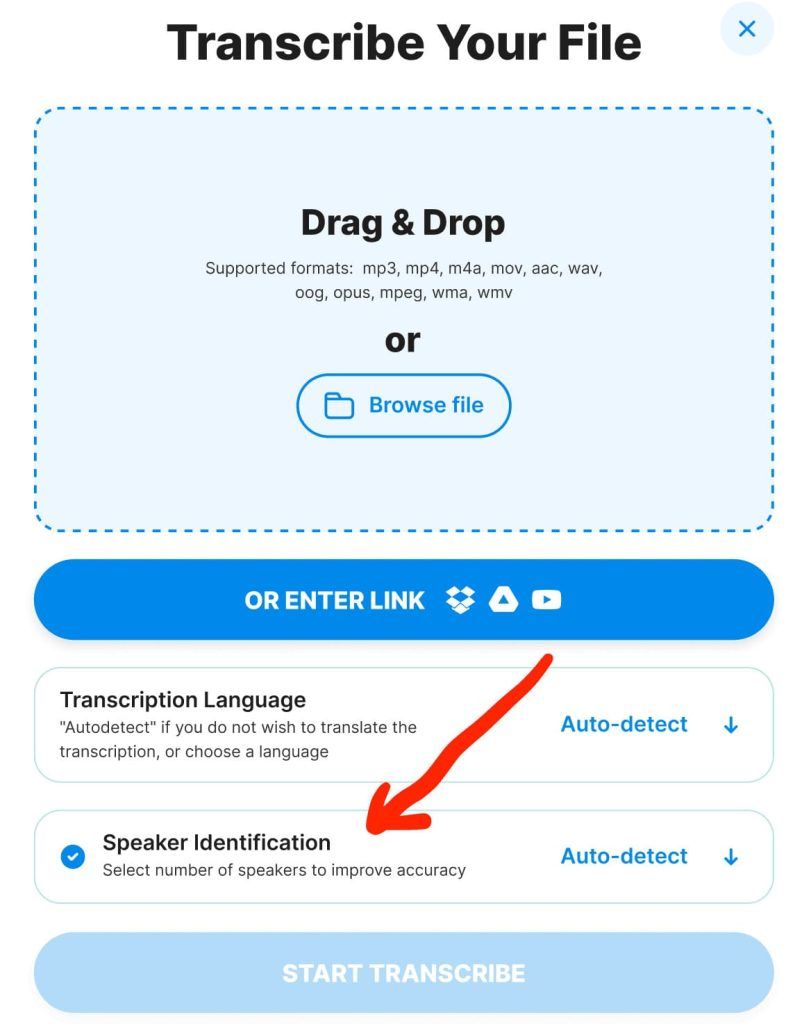
当社のツールでは、音声の複雑さに応じて2人から8人までの話者を認識するよう選択できます。話者識別を制限したり自動化したりする他の文字起こしツールと違い、TranscribetoText.aiでは自分で設定できます。話者数を指定すると、特に声のトーンが似ている話者がいる場合に精度が向上します。
当社のサービスは、現在市場で最も高度な文字起こし・認識モデルのひとつであるOpenAIのWhisperモデルを使用しています。Whisperは高精度を目指して作られており、さまざまな方言、なまり、言語の処理に特に優れています。Whisperは、文脈を理解し、発言の重なりや背景ノイズのある難しい音声条件でも話者を区別できる高度な機械学習技術により、話者分離において多くの従来モデルを上回る性能を発揮します。
話者分離にWhisperを使うメリット
Whisperモデルは、従来のモデルが苦手とする複雑な音声環境で真価を発揮します。シンプルなモデルと違い、Whisperは微妙なトーンの違いを認識し、話者の切り替わりを検出できるため、声をより高精度に区別できます。これは、意思決定のために明確さが欠かせないビジネス会議や、証拠として正確な話者の割り当てが必要な法的手続きで特に役立ちます。
ノイズ、多様な話し方、さまざまななまりへの対応力において、Whisperに並ぶものはありません。TranscribetoText.aiのユーザーにとって、これは文字起こしが正確なだけでなく、複雑な状況でも非常に信頼できることを意味します。Whisperは複数の言語にも対応しているため、当社のサービスは多言語の録音にも対応できます。これは、グローバル組織や多様な言語環境で働くチームにとって重要な機能です。
話者分離の実際の活用例
- 社内会議
大企業では、会議の文字起こしは決定事項の追跡、アクションアイテムの記録、透明性の確保に欠かせません。話者分離により個々の発言が明確に識別されるため、フォローアップや責任の所在の明確化に役立ちます。各参加者の発言を正確にタグ付けした文字起こしを参照できれば、時間を節約し、誤解を最小限に抑えられます。特に複数の部署や役割が関わるチームで効果的です。 - メディアのインタビュー
記者や研究者は、各話者の発言を識別することが不可欠なインタビューを頻繁に行います。インタビューでは、各発言を正しい話者に割り当てることで、事実に忠実で改変のない記録が残せます。たとえば複数の広報担当者が参加する記者会見でも、話者分離により誰が何を言ったかが文字起こしに正確に反映され、一人ひとりのコメントの正確性が保たれます。 - カスタマーサービスの録音
顧客とのやり取りでは、サポート担当者と顧客の間で複雑な対話が交わされることがよくあります。話者分離により、品質管理、研修、顧客満足度の向上を目的としたやり取りの分析が可能になります。会話の各当事者を識別することで、カスタマーサービスチームは課題、担当者のパフォーマンス、顧客の苦情の細かなニュアンスをより明確に把握できます。 - フォーカスグループと調査ディスカッション
市場調査担当者にとって、フォーカスグループの各参加者の声を正確に記録することは非常に重要です。話者分離により回答を個別に分析でき、インサイトを正しい参加者に結び付けられます。この正確さが、傾向、独自の視点、属性ごとのフィードバックの把握に役立ち、分析やレポートの質を高めます。
話者分離を効果的に使うコツ
- 話者数を明確に設定する
TranscribetoText.aiの話者分離機能の強みのひとつは、話者数を2人から8人の範囲で選べることです。正確な話者数を設定すると、認識精度が向上します。たとえば参加者が4人とわかっているパネルディスカッションでは、話者数を4に設定することで、モデルが適切な人数の声に合わせて処理し、発言の割り当てミスを減らせます。 - 高品質な音声を使う
話者分離も、あらゆる文字起こしと同様に、音声品質の良さから大きな恩恵を受けます。背景ノイズ、発言の重なり、不明瞭な音声は話者分離に影響する可能性があります。できるだけ静かな環境で、品質の良い録音機材を使って録音しましょう。これによりWhisperモデルが最大限の性能を発揮し、話者の区切りがより明確になり、混乱を減らせます。 - TranscribetoText.aiの話者ラベル機能を活用する
当プラットフォームでは、話者に「話者1」「話者2」などのラベルを付けたり、文字起こし後に実名や役職に合わせてラベルをカスタマイズしたりできます。この機能は、特に文字起こしを広いチームで使ったり正式な文書に使ったりする場合に、整理しやすさの面で役立ちます。文字起こし後に話者を実名や役割に変更すると、議論をより直感的に追えるようになります。 - 確認と編集
Whisperは高い精度を誇りますが、文字起こしの正確さを確保するために多少の調整が必要な場合もあります。さっと確認すれば話者の割り当てをチェックでき、誤りがあればすぐに修正できます。TranscribetoText.aiの使いやすい編集ツールなら、エクスポートや共有の前に最終調整を簡単に行えます。
AIの進歩で話者分離を強化
TranscribetoText.aiは、最先端のAIの改良を取り入れながらプラットフォームを常に進化させ、文字起こし技術の最前線に立ち続けています。OpenAIのWhisperモデルとの連携により、ユーザーは最先端の話者認識機能を利用でき、文字起こしの精度と使いやすさに新たな基準をもたらしています。業界の進歩に合わせて当社のツールも進化し、ユーザーが常に話者分離の最良の技術を利用できるようにしていきます。