Produkt 4 Min. Lesezeit
Sprecherdiarisierung in der Transkription: ein starkes Werkzeug für Klarheit und Präzision
Bei TranscribetoText.ai möchten wir Ihnen die bestmögliche Transkriptionserfahrung bieten – dazu gehört auch die Sprecherdiarisierung, die Transkripte genauer und nützlicher macht. Sprecherdiarisierung – manchmal auch „Sprechererkennung“ oder „Sprecherzuordnung“ genannt – ist der Prozess, Sprecher in einer Audiodatei zu erkennen und voneinander zu trennen. Diese Funktion ist entscheidend für Transkripte, die nicht nur festhalten, was gesagt wird, sondern auch, wer es sagt.
Warum Sprecherdiarisierung bei der Transkription wichtig ist
Sobald mehrere Personen sprechen, wird es in einem Textdokument schnell schwierig, dem Gesprächsverlauf zu folgen. Die Sprecherdiarisierung markiert jeden Sprecherwechsel – besonders nützlich bei Meetings, Interviews, Podiumsdiskussionen und Kundenservice-Aufnahmen. Ohne sie wirkt eine Transkription wie ein einziger Monolog: Es ist kaum zu erkennen, wer spricht, was vor allem bei wichtigen Diskussionen mit unterschiedlichen Standpunkten zu Verwirrung führt.
Dank Sprecherzuordnung lässt sich ein Transkript wie ein Live-Gespräch verfolgen, und Beiträge und Absichten sind leichter zu erkennen. Das wird unverzichtbar, wenn die Unterscheidung der Sprecher entscheidend ist – etwa bei juristischen Transkriptionen, wissenschaftlicher Forschung, Medieninterviews und der Analyse von Kundenfeedback. Indem wir unterschiedliche Stimmen erkennen und das Gesagte einzelnen Sprechern zuordnen, entstehen Transkriptionen, die Sie direkt zitieren, belegen oder sicher analysieren können.
So funktioniert die Sprecherdiarisierung bei TranscribetoText.ai
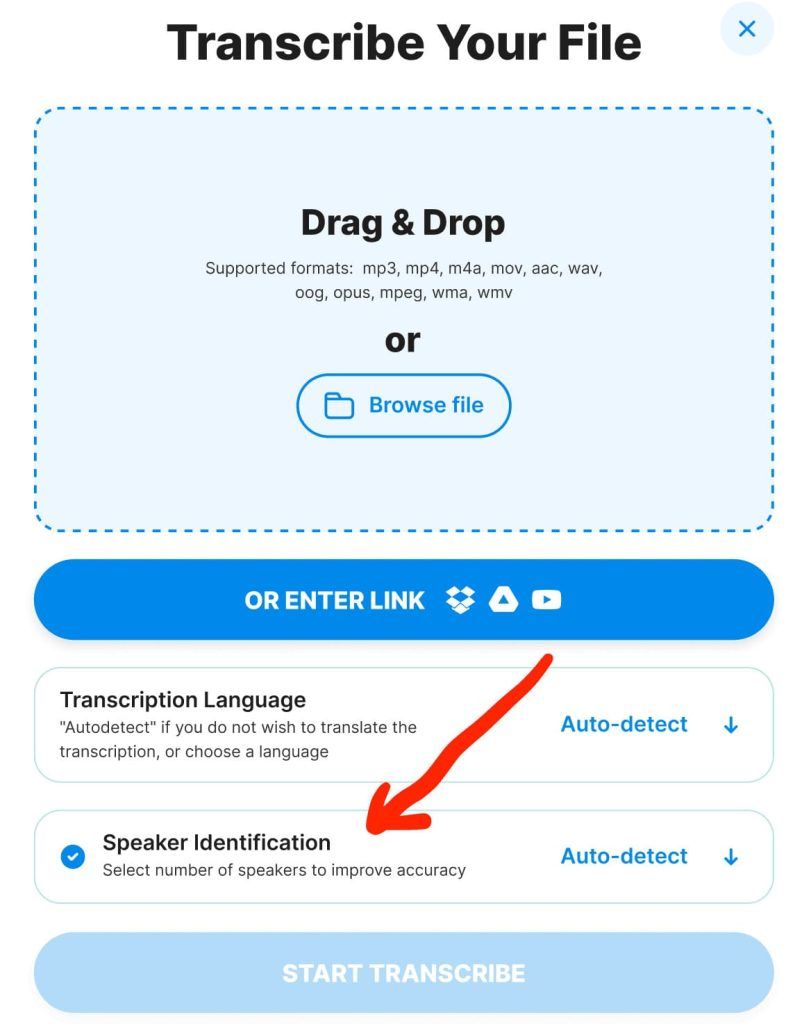
Mit unserem Tool können Sie je nach Komplexität des Audios zwischen zwei und acht Sprechern erkennen lassen. Anders als andere Transkriptionstools, die die Sprechererkennung einschränken oder automatisieren, gibt Ihnen TranscribetoText.ai die Kontrolle. Die Angabe der Sprecheranzahl verbessert die Genauigkeit, besonders wenn sich die Stimmen ähneln.
Unser Dienst nutzt das Whisper-Modell von OpenAI, eines der fortschrittlichsten Transkriptions- und Erkennungsmodelle auf dem Markt. Whisper ist auf hohe Genauigkeit ausgelegt und kommt besonders gut mit verschiedenen Dialekten, Akzenten und Sprachen zurecht. Bei der Sprecherdiarisierung übertrifft Whisper viele herkömmliche Modelle – dank moderner Machine-Learning-Verfahren, die den Kontext verstehen und Sprecher selbst unter schwierigen Bedingungen wie überlappender Sprache oder Hintergrundgeräuschen unterscheiden.
Vorteile von Whisper für die Diarisierung
Das Whisper-Modell glänzt in komplexen akustischen Umgebungen, in denen herkömmliche Modelle oft scheitern. Anders als einfachere Modelle erkennt Whisper feine Unterschiede in der Stimmfarbe und bemerkt Sprecherwechsel, wodurch Stimmen genauer unterschieden werden. Das ist besonders wertvoll in Geschäftsmeetings, in denen Klarheit für Entscheidungen entscheidend ist, oder in Gerichtsverfahren, in denen eine korrekte Sprecherzuordnung als Beweis notwendig ist.
Whisper ist unübertroffen im Umgang mit Störgeräuschen, unterschiedlichen Sprechweisen und vielfältigen Akzenten. Für Nutzer von TranscribetoText.ai bedeutet das: Transkriptionen sind nicht nur genau, sondern auch in komplexen Situationen außergewöhnlich zuverlässig. Da Whisper zudem viele Sprachen beherrscht, kann unser Dienst auch mehrsprachige Aufnahmen verarbeiten – ein wichtiges Merkmal für internationale Organisationen und Teams in vielsprachigen Umfeldern.
Sprecherdiarisierung in der Praxis
- Unternehmensmeetings
In großen Unternehmen sind Meeting-Transkripte unverzichtbar, um Entscheidungen nachzuverfolgen, Aufgaben festzuhalten und Transparenz zu wahren. Die Diarisierung sorgt dafür, dass einzelne Beiträge klar zugeordnet sind – hilfreich für Nachverfolgung und Verantwortlichkeit. Ein Transkript, das die Aussagen jedes Teilnehmenden korrekt kennzeichnet, spart Zeit und verringert Missverständnisse, besonders in Teams mit verschiedenen Abteilungen oder Rollen. - Medieninterviews
Journalisten und Forschende führen häufig Interviews, bei denen die Zuordnung jedes Beitrags entscheidend ist. Wird jede Aussage dem richtigen Sprecher zugeordnet, entsteht ein sachliches, unverfälschtes Protokoll. Bei einem Presseinterview mit mehreren Sprechern etwa stellt die Diarisierung sicher, dass das Transkript genau wiedergibt, wer was gesagt hat, und die Aussagen jedes Einzelnen unverfälscht bleiben. - Kundenservice-Aufnahmen
Kundengespräche umfassen oft komplexe Dialoge zwischen Supportmitarbeitenden und Kunden. Mit der Diarisierung können Unternehmen Gespräche für Qualitätskontrolle, Schulungen und Kundenzufriedenheit analysieren. Da jede Gesprächspartei erkannt wird, gewinnen Serviceteams klarere Einblicke in Schwachstellen, die Leistung der Mitarbeitenden und die Details von Kundenbeschwerden. - Fokusgruppen und Forschungsdiskussionen
Für Marktforscher ist es von unschätzbarem Wert, die Stimme jedes Teilnehmenden einer Fokusgruppe genau zu erfassen. Dank Diarisierung lassen sich Antworten einzeln auswerten und Erkenntnisse den richtigen Personen zuordnen. Diese Genauigkeit hilft, Trends, besondere Perspektiven und zielgruppenspezifisches Feedback zu erkennen, und verbessert die Qualität von Analysen und Berichten.
Tipps für eine effektive Sprecherdiarisierung
- Sprecheranzahl klar festlegen
Eine Stärke der Diarisierung von TranscribetoText.ai ist die Möglichkeit, die Anzahl der Sprecher von zwei bis acht festzulegen. Eine korrekte Sprecheranzahl verbessert die Erkennungsgenauigkeit. Bei einer Podiumsdiskussion mit vier bekannten Teilnehmenden etwa hilft die Einstellung „vier“ dem Modell, sich auf die richtige Anzahl an Stimmen einzustellen, und verringert Fehlzuordnungen. - Hochwertiges Audio verwenden
Wie jede Transkription profitiert auch die Diarisierung stark von guter Audioqualität. Hintergrundgeräusche, überlappende Sprache und undeutliches Audio können sie beeinträchtigen. Nehmen Sie nach Möglichkeit in ruhiger Umgebung und mit guter Aufnahmetechnik auf. So arbeitet das Whisper-Modell optimal, trennt Sprecher klarer und vermeidet Verwechslungen. - Sprecherbezeichnungen in TranscribetoText.ai nutzen
Auf unserer Plattform können Sprecher als „Sprecher 1“, „Sprecher 2“ usw. gekennzeichnet oder nach der Transkription mit echten Namen oder Funktionen benannt werden. Das schafft Übersicht, besonders wenn das Transkript von einem größeren Team oder in offiziellen Dokumenten genutzt wird. Mit echten Namen oder Rollen lassen sich Diskussionen nach der Transkription intuitiver nachvollziehen. - Prüfen und bearbeiten
Whisper ist sehr genau, doch in manchen Fällen sind kleine Korrekturen nötig. Eine kurze Durchsicht bestätigt die Sprecherzuordnungen, sodass Sie Fehlzuordnungen schnell erkennen und korrigieren. Mit den benutzerfreundlichen Bearbeitungstools von TranscribetoText.ai erledigen Sie diesen letzten Schliff ganz einfach, bevor Sie das Transkript exportieren oder teilen.
Bessere Diarisierung durch KI-Fortschritte
Bei TranscribetoText.ai entwickeln wir unsere Plattform ständig weiter und integrieren modernste KI-Verbesserungen, um an der Spitze der Transkriptionstechnologie zu bleiben. Dank des Whisper-Modells von OpenAI erhalten unsere Nutzer Zugang zu hochmoderner Sprechererkennung, die neue Maßstäbe für Genauigkeit und Benutzerfreundlichkeit setzt. Mit dem Fortschritt der Branche wachsen auch unsere Tools – damit Sie stets die beste verfügbare Technologie für die Sprecherdiarisierung nutzen.